Если данные — нефть, то ИИ — сланцевая революция
Как распознать невостребованные информационные активы и что с ними делать
 ·
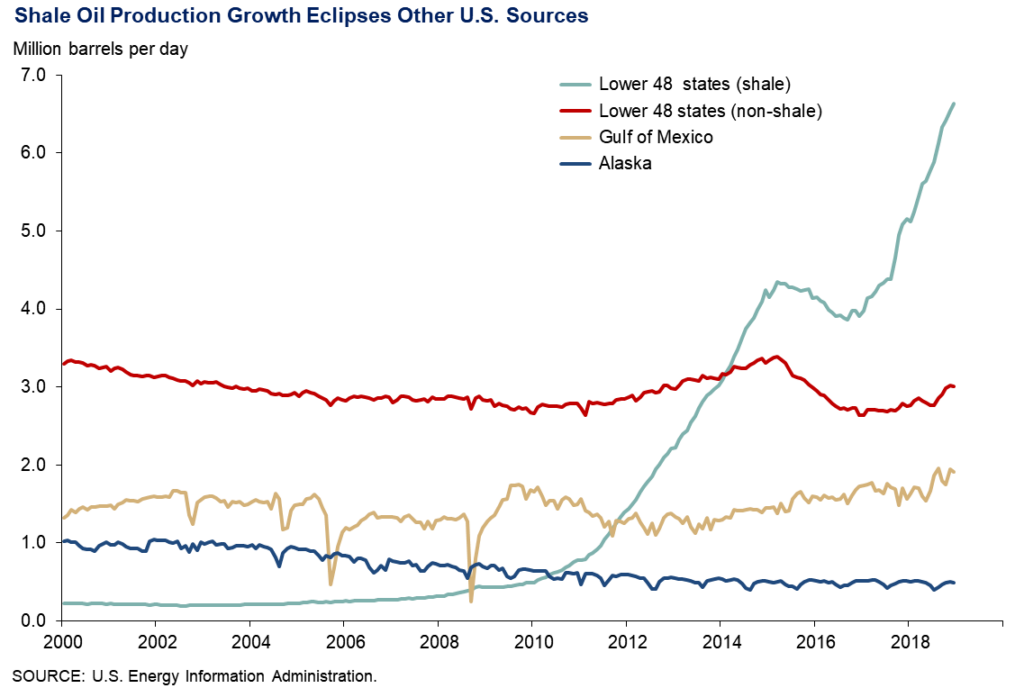
10 декабря 1967 года правительство США взорвало ядерное устройство мощностью 29 килотонн под горной породой недалеко от Дульсе, штат Нью-Мексико, в попытке добыть сланцевый газ.
Сегодня такой подход к добыче природного газа кажется карикатурно экстремальным. В этом и суть: люди знали, что сланцевый газ существует и что он обладает экономической ценностью. Но лишь сланцевая революция начала 2000-х смогла сделать то, чего не добились ядерные взрывы: превратить недоступный ресурс в экономически извлекаемый.
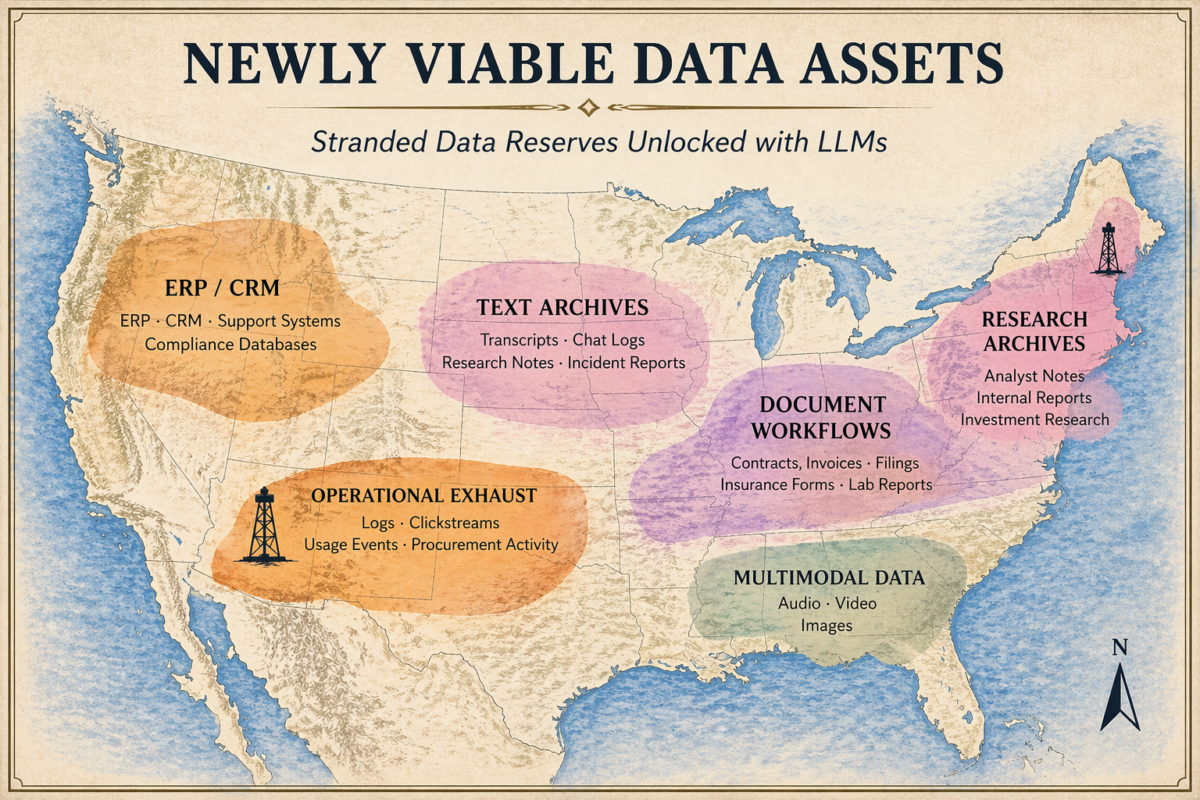
До появления LLM значительная часть неструктурированных данных в мире напоминала сланцевые месторождения 1960-х: их ценность была очевидна, они были широко доступны, но разрабатывать их было слишком дорого. Внутренние базы данных, архивы текстов, журналы событий, видео и другие неоднородные источники давно обладали огромным потенциалом, но часто оставались экономически невостребованными.
LLM изменили экономику процесса. Теперь можно значительно дешевле извлекать информацию из неструктурированного сырья и превращать её в структурированные временные ряды, пригодные для систематических инвесторов и других покупателей.
ИИ не делает ценным каждый набор данных, но расширяет круг данных, разработка которых стала экономически оправданной. Поэтому организации, владеющие прежде недоступными информационными активами, возможно, теперь располагают ценным ресурсом.
Если работа вашей организации основана на неструктурированных текстах — обращениях в поддержку, продажах, исследованиях, комплаенсе или операционных данных, — прежняя высокая стоимость превращения этих данных в продукт может уже не быть препятствием.
Мой взгляд на эти изменения сформировался по обе стороны рынка: раньше я управлял систематическим фондом, который оценивал внешние наборы данных, а теперь работаю с владельцами данных.
Что изменил ИИ
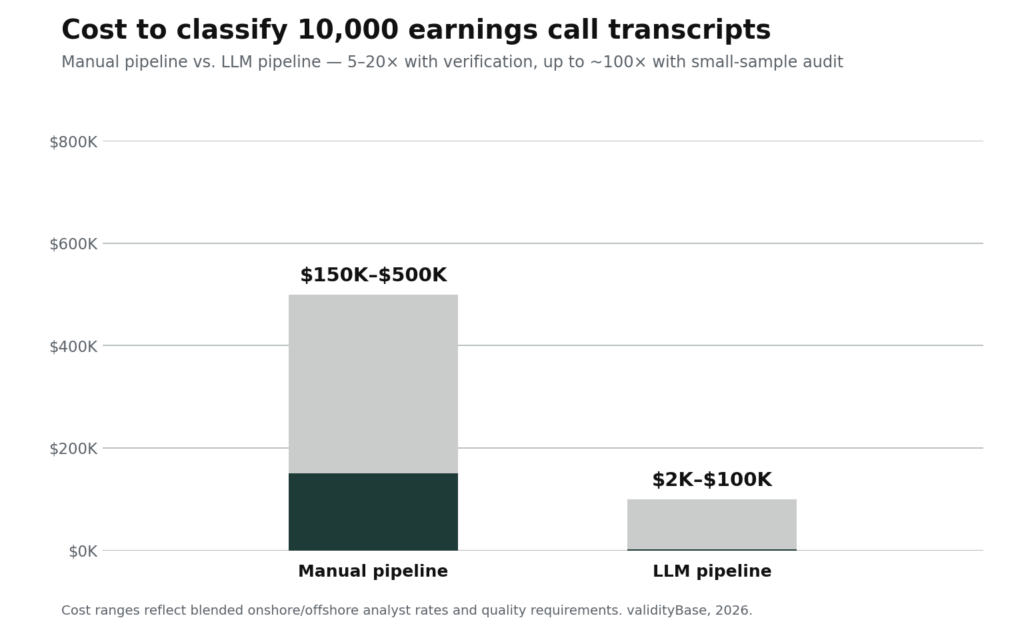
Ещё недавно извлекать сигналы из неструктурированных данных было чрезвычайно дорого. Классификация 10 000 расшифровок звонков по финансовым результатам — по упоминаниям компаний, тональности и событиям — традиционным способом заняла бы около 7 500 часов. В зависимости от команды это примерно 150 000–500 000 долларов работы квалифицированных аналитиков. Если бы вы были уверены в ценности данных, на таком ручном процессе можно было бы построить бизнес. Но большинство владельцев данных такой уверенности не имели и за него не брались.
До появления LLM значительная часть неструктурированных данных напоминала сланцевые месторождения 1960-х: они были ценны и доступны, но разрабатывать их было слишком дорого.
LLM сократили эти затраты в 5–20 раз, если результаты проверяет человек, и примерно до 100 раз, если достаточно аудита небольшой выборки. Похожие улучшения наблюдаются при разметке сущностей, сопоставлении идентификаторов и классификации тем. Для многих владельцев данных стоимость преобразования неоднородных текстов в показатели, пригодные для инвесторов, снизилась настолько, что вопрос меняется с «можем ли мы разработать эти данные?» на «стоит ли это делать?».
Очевидные кандидаты — объёмные текстовые источники: расшифровки и исследовательские заметки. Представьте небольшую аналитическую компанию, в отчётах которой за 15 лет прослеживается изменение взглядов на целую отрасль; организатора конференций с десятилетним архивом выступлений руководителей; или отраслевое издание с многолетним архивом публикаций и профилей компаний.
Но теперь можно работать и с частично структурированными следами обычной деятельности: заявками в поддержку, заметками в CRM, журналами закупок, заказами и записями по комплаенсу. Данные, нормализация которых в большом масштабе прежде стоила слишком дорого, стали доступнее.
Не уверены, относится ли это к вам? Если другим сложно воспроизвести ваши данные и их можно агрегировать в измеримые показатели по публичным компаниям или активам, читайте дальше.
Самый прямой путь к коммерческой ценности обычно лежит через простые и понятные количественные признаки: интенсивность обсуждения темы, динамику тональности, показатели на уровне активов. Покупатели могут систематически оценить такие данные. Систематические инвестиции часто служат лучшим входом на рынок данных: у таких инвесторов есть спрос на новые источники, стандартные требования к подготовке данных и строгий процесс оценки. В результате получается понятный, хорошо документированный продукт, который позже можно адаптировать для других покупателей.
Стратегические варианты: не каждой компании нужно становиться поставщиком данных
Большинству компаний не стоит разрабатывать каждый невостребованный информационный актив. Монетизация часто требует нескольких лет, внимания руководства, профильных специалистов и капитала — ресурсов, нужных и основному бизнесу.
Но некоторые такие активы действительно стали эквивалентом сланцевых запасов Западного Техаса. Тогда вопрос в том, как реализовать их ценность. И точно так же, как не каждый землевладелец Техаса становился нефтегазовой компанией, не каждому владельцу данных нужно становиться поставщиком альтернативных данных. Во время сланцевого бума многие владельцы земли сотрудничали со специализированными компаниями, которые разрабатывали месторождения за них. На рынке данных возникают похожие модели.
Есть несколько реалистичных путей, различающихся трудозатратами, риском и потенциальной выгодой.
Большинству компаний не стоит разрабатывать каждый невостребованный информационный актив.
Вариант A: продать права на данные
Это самый простой путь: предоставить лицензию на доступ к данным или права на их использование и позволить другой компании разработать продукт. Он подходит, если вы не хотите создавать собственную продуктовую команду, а ваши данные достаточно интересны покупателю.
Обратная сторона в том, что необработанные данные, как и неосвоенные запасы, обычно продаются со скидкой. Покупатель закладывает стоимость разработки и риск того, что готовый продукт не найдёт спроса.
Чаще всего естественный покупатель — действующий поставщик данных, который ищет новый источник: например, компания, работающая с веб-трафиком, приобретает данные о кликах. Другой вариант — специализированная компания по разработке информационных продуктов.
Вариант B: сотрудничать со специалистом
Если вы хотите получить большую долю потенциальной прибыли, чем при простой лицензии, можно заключить партнёрство. Вы предоставляете исходные данные и знание предметной области, партнёр — инженерную разработку, создание продукта и часто каналы продаж. Вы делите доход, но начинаете зарабатывать быстрее, не создавая собственную продуктовую команду.
Для многих организаций это средний путь: заметный потенциал без превращения в полноценный бизнес по продаже данных. validityBase — один из примеров компании, которая так работает с владельцами данных.
Вариант C: разработать продукт самостоятельно
Этот путь даёт максимальный потенциал дохода, но требует наибольших вложений. Вы отвечаете за всё: извлечение данных, подготовку продукта, документацию, доставку, поддержку и продажи. Вы создаёте и обслуживаете процесс обработки, выстраиваете отношения с клиентами и получаете весь доход.
Нужны специальные знания не только в инженерии данных. Предстоит выявить в данных прогностические признаки и представить их в форме, совместимой с процессами систематических инвесторов. Это полноценный продуктовый бизнес. Для организаций с подходящими данными и готовностью инвестировать именно здесь может сосредоточиться наибольшая ценность.
Три пути к реализации ценности ваших данных
Выберите подходящий баланс усилий, скорости выхода на рынок и потенциальной выгоды.
| ВАРИАНТ AПродать права на данные | ВАРИАНТ BСотрудничать со специалистом | ВАРИАНТ CРазработать продукт самостоятельно | |
|---|---|---|---|
| Что вы предоставляете | Доступ к данным / права использования | Данные + знание предметной области | Данные + полноценную продуктовую команду |
| Усилия | Небольшие | Средние | Значительные |
| Ваша доля дохода | Ниже из-за необработанных данных | Разделяется с партнёром | Весь доход остаётся вам |
| Главный риск | Более низкая реализованная стоимость | Качество работы и совместимость с партнёром | Риск отсутствия спроса на продукт |
| Кому подходит | Владельцам, которые не хотят создавать продуктовую команду | Тем, кто хочет получить выгоду, не создавая отдельный бизнес по продаже данных | Тем, у кого есть подходящие данные и готовность инвестировать в продукт |
validityBase, 2026.
Даже если в конечном счёте вы собираетесь продать данные или найти партнёра, предварительная подготовка может существенно повысить их ценность. Большинство тестов альтернативных данных проваливаются — по некоторым оценкам, около 80%. Поэтому сравнительно небольшая работа на раннем этапе особенно полезна: базовая структуризация, сопоставление сущностей и документация делают данные привлекательнее для покупателей и партнёров. Это уменьшает объём их работы и показывает, что вы готовы отвечать за качество набора данных.
У вас есть невостребованные данные?
Запишитесь на 30-минутную рабочую встречу. Мы посмотрим, какими данными вы располагаете, расскажем, что стоит разрабатывать и как оцениваются похожие наборы данных. Или напишите мне на dan@vbase.com.
Уже планируете разработку? Наш контрольный список готовности к тесту поможет подготовиться к требованиям систематических покупателей.

Before vBase, Dan founded Clerkenwell Asset Management, a systematic hedge fund that bought and evaluated external data to build trading strategies. He brought that buyer-side perspective to vBase, which builds infrastructure for teams making credible predictive claims.